Broadcom FY2026 Q3:从客户的计算成本,看定制芯片的需求与利润
原分析日期:16 Sep 2026。财报发布日期:2 Sep 2026;报告期截至 2 Aug 2026。
注记 · 23 Oct 2026 按客户成本、研发、生产、部署和收入重新整理。金额默认单位为十亿美元(b)。财报数据采用公司披露,成本测算注明研究机构与适用条件。
客户通过产品价格支付研发、制造和供应商利润
客户购买 NVIDIA GPU,通过产品售价支付制造、研发、软件生态的成本和 NVIDIA 的利润。采用定制 XPU 后,客户直接承担部分研发和软件投入,再向 Broadcom 采购量产芯片。 两条路线的经济性,取决于这些支出合计后,完成同样任务需要多少钱。
XPU 是本文对定制 AI 加速器的统称,Google 的 TPU、Meta 的 MTIA 是具体产品。它们拥有自己的计算单元、内存接口和执行软件,可以承担训练或推理任务。Broadcom 按客户规格开发和供应这类芯片。(Broadcom FY2025 10-K)
客户将任务部署到 XPU 后,相应的计算硬件采购便从 GPU 转向 XPU。替换主要发生在新增采购和设备更新时:已有 GPU 继续服务原有任务,适合定制硬件的新增任务进入 XPU 集群。客户的 AI 计算需求持续增长时,两类芯片的采购可以同时增加。
| 客户支出 | NVIDIA GPU 路线 | 定制 XPU 路线 |
|---|---|---|
| 芯片研发 | 通过产品采购间接支付 | 自身设计团队投入,以及合同约定的开发付款 |
| 计算硬件 | 采购 GPU 服务器或机架 | 采购 XPU 服务器或机架,价格包含供应商利润 |
| 软件 | 使用 NVIDIA 生态,承担模型适配、调优和运维 | 建设或适配硬件软件后端,承担模型迁移、调优和运维 |
| 数据中心 | 支付网络、电力、散热和机房费用 | 按 XPU 系统配置支付相应费用 |
| 平台转换 | 维护和升级现有平台 | 支付迁移、验证及过渡期两套系统并存的费用 |
Broadcom 的收入确认政策列有一次性工程开发费(NRE)安排。具体项目怎样分担研发投入、怎样确定量产价格,由合同约定;单个 AI 项目的费用明细仍待公开披露。(Broadcom FY2025 10-K,收入确认政策)
从传统定制芯片到 AI 扩张:2025 年前后的增长曲线
新增 · 26 Oct 2026
Broadcom 的定制芯片能力长期服务于通信、数据处理和专用计算。以 2025 年前后观察业务变化,可以看到两条需求来源:已有业务为提高处理效率而采用专用芯片,AI 客户为扩大训练和推理规模而持续增加加速器及网络采购。公司披露显示,AI 的收入加速已发生在 2023–2024 年,2025 年则成为 AI 收入超过半导体收入一半的节点。
早期需求:通信设备和视频处理
2014 年,后来并入现今集团的 Broadcom Corporation 已在年报中列出 Custom Silicon Products:把客户自己的知识产权与其他电路整合到一颗 ASIC 中,为客户取得成本、功耗和性能收益。当时公司的主要市场是有线与无线通信,定制化是设备厂商实现产品差异和系统集成的一种方式。(Broadcom Corporation 2014 年报,Custom Silicon Products)
到 2023 年,SemiAnalysis 记录的 Broadcom 定制产品已经包括定制路由与交换芯片、YouTube 视频编码芯片,以及 Google TPU、Meta MTIA。该机构当时估计,Custom Silicon 已发展为年收入约 2–3b 以上的业务;这是包含 AI 项目的研究估计,公开年报尚未提供完整的非 AI 定制芯片逐年收入。(SemiAnalysis,2023 年业务梳理)
YouTube 视频处理提供了清晰的非 AI 需求案例。用户上传的视频需要转换为适合不同设备、清晰度和网络条件的版本。视频量增长、分辨率提高,以及更复杂的压缩格式,都会增加计算开支。Google 在 2021 年发表的 VCU 论文报告,专用视频加速器在真实数据中心任务中的效率,是此前经过优化的无加速器系统的 20–33 倍。(Google,视频加速器设计与部署论文)
这类需求与本文开头的成本逻辑一致:客户已有大量重复任务,投入专用硬件开发,以后续每次处理节省的资源回收投入。视频分钟数、编码复杂度和设备升级决定业务量;工程能力沿产品迭代积累。
财务曲线:AI 规模上升,非 AI 业务经历收缩
下面按公司披露的 AI 半导体与其余半导体收入观察需求变化。AI 半导体包含定制加速器和 AI 网络;其余部分包含无线、宽带、存储及传统网络等产品。非 AI 定制芯片的规模,仍需在更细的产品披露中追踪。
| 财年 | 半导体收入 | AI 半导体收入 | 非 AI 半导体收入 | AI 占半导体收入 |
|---|---|---|---|---|
| FY2020 | 17.3 | 占比低于 5% | 占比高于 95% | <5% |
| FY2021 | 20.4 | 占比低于 5% | 占比高于 95% | <5% |
| FY2022 | 25.8 | 约 2.6(推算) | 约 23.2(推算) | 约 10% |
| FY2023 | 28.2 | 约 3.8 | 约 24.4(推算) | 约 13.5% |
| FY2024 | 30.1 | 约 12.2 | 约 17.9(推算) | 约 40.5% |
| FY2025 | 36.9 | 约 20.2 | 约 16.7(推算) | 约 54.8% |
金额单位为 b。FY2020–2022 的 AI 占比来自公司 2024 年投资者演示;FY2022 金额按约 10% 占比推算。FY2023–2025 AI 金额采用公司后续披露,非 AI 为半导体总收入减 AI 收入。表中金额四舍五入,图与下文增量采用原始半导体收入及披露的近似 AI 金额计算。(FY2021 财报,含 FY2020;FY2023 财报,含 FY2022;FY2024 财报;FY2025 财报;2024 年投资者演示,第 14 页;2025 年股东委托书;2026 年股东委托书)
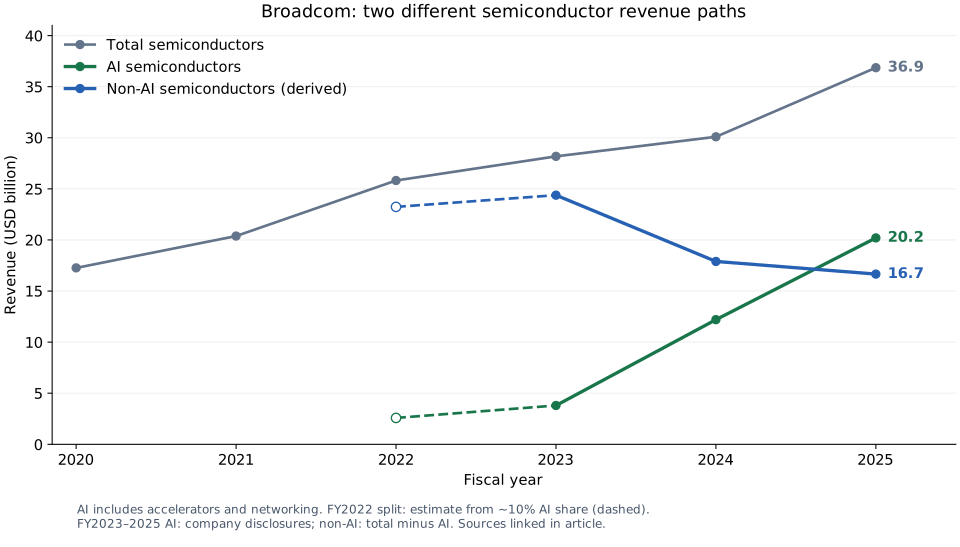
FY2020–FY2022 是传统业务占主导的扩张阶段:半导体收入从 17.3b 升至 25.8b,AI 占比在这段时期从低于 5% 升至约 10%。通信、无线、宽带和存储等需求构成了当时绝大部分业务,AI 需求随后在这套产品和工程基础上扩大。
FY2024 最能体现两类需求的差异。 AI 收入增加约 8.4b,非 AI 收入减少约 6.5b,两者合计后半导体收入增加约 1.9b、增长约 7%。公司当年披露,AI 收入同比增长约 220%,来自 XPU 和以太网产品。增长的新需求与传统业务下行,在同一份财报中同时出现。(FY2024 财报)
到 FY2025,AI 收入再增加约 8.0b,非 AI 收入减少约 1.2b,半导体总收入增加约 6.8b、增长约 22%。AI 已成为增长的主要来源,并占半导体收入约 55%。(FY2025 财报;2026 年股东委托书)
需求变化怎样放大既有能力的价值
从需求机制看,传统定制项目围绕具体设备或任务优化,订单随设备出货、业务量和产品升级展开。AI 项目把这套工程能力用于持续扩张的计算集群:客户既要增加计算芯片,也要增加芯片间的数据传输能力。
Broadcom 的 2024 年演示资料给出了集群规模的变化:每个集群的 XPU 数量,从 2022 年的 4,000 颗以上,升至 2023 年的 10,000 颗以上、2024 年的 30,000 颗以上。单个部署规模扩大,使已经验证的接口、封装和量产流程承接更多芯片出货,并带动连接产品需求。(2024 年投资者演示,第 17 页)
这个案例显示,成熟的定制芯片能力,可以在客户工作量急剧扩张时获得新的增长曲线。 传统业务提供长期积累的 IP、实现与交付能力,AI 工作负载带来加速器及配套网络的新增需求。判断增长持续性,需要继续观察客户计算量、单位任务效率和后续部署,而传统业务仍按各自的终端需求与库存周期运行。
从业务任务到量产部署,各环节怎样分工
客户定义要优化的任务
需求首先来自客户已有的业务:内容推荐、广告排序、模型训练,以及向用户提供生成式 AI 推理。客户能够从生产系统中测量请求量、响应速度、设备利用率和成本,确定值得优化的任务。
Meta 已披露部署数十万颗 MTIA,为内容和广告推理服务。其后续路线以生成式 AI 推理为重点,并采用多种芯片分别满足不同任务。长期、大规模的业务使用,为定制硬件提供了持续的工作量。(Meta,MTIA 路线说明)
客户需要把业务要求转成硬件目标,例如在给定响应时间内处理多少请求、需要多少内存、芯片之间交换多少数据,以及每个机架允许使用多少电力。这些目标决定后续架构设计。
客户与 Broadcom 完成芯片设计
客户从自身任务出发,定义计算、内存和通信需求;Broadcom 提供可复用的芯片设计模块(IP),并参与设计集成、验证、物理实现和封装工程。物理实现要把设计落实为满足频率、面积、功耗和可靠性要求的电路。
Broadcom 公开的 3.5D 平台将计算、内存和输入输出接口集成到同一封装中,并提供关键接口 IP 的验证与生产准备。它把多年积累的底层模块和工程流程用于客户项目。(Broadcom 3.5D XPU 平台公告)
2026 年 4 月,Meta 宣布与 Broadcom 扩大多代合作,范围涵盖芯片设计、先进封装和网络。双方合作已延伸到连续多代产品的规划和交付。(Meta 与 Broadcom 的合作公告)
软件团队把模型映射到硬件
模型需要经过软件转换,才能在芯片上高效率执行。编译器后端把模型运算映射到硬件支持的指令和数据布局,算子实现负责具体计算,运行时管理内存、执行和同步。
NVIDIA 的 Tensor Cores 提供矩阵计算能力,TensorRT 等工具优化执行方式、融合操作并减少数据搬运。客户在这套成熟工具上完成模型适配和性能调优。(NVIDIA GPU 性能说明;TensorRT 优化说明)
定制 XPU 路线需要客户和相关平台团队维护对应的软件能力。软件成熟度直接影响芯片利用率、模型覆盖范围和迁移时间。Meta 的路线采用 PyTorch、vLLM、Triton 等软件生态,并通过模块化设计加快产品部署。(Meta,MTIA 路线说明)
供应商完成制造、封装与测试
设计完成后,晶圆厂制造电路,内存供应商提供高带宽内存(HBM),封装与测试环节将计算芯片、内存和接口组合成可交付产品。制造成本受到制程、芯片面积、内存配置、封装复杂度和良率影响。
Broadcom 依赖外部制造供应链。本财年前三季度,合同制造商为其生产的晶圆约 95% 来自台积电。先进制程、内存和封装的供应情况,会影响交付量、成本及时间。(FY2026 Q3 10-Q,供应链风险)
系统厂商和客户完成部署
芯片随后进入服务器、机架和数据中心。客户在真实任务中验证吞吐、响应时间、利用率、耗电和运行稳定性。网络、电力、散热、软件与计算硬件共同决定有效产出。
| 阶段 | 主要参与者 | 交付结果 |
|---|---|---|
| 任务与架构定义 | 客户业务、基础设施及芯片团队 | 任务范围、性能和成本目标 |
| 芯片实现 | 客户、Broadcom 及相关合作方 | 可制造、可验证的芯片设计 |
| 软件适配 | 客户及平台软件团队 | 能够运行并持续优化的模型与软件 |
| 制造和封装测试 | 晶圆厂、内存和封测供应商 | 达到质量要求的芯片产品 |
| 系统部署 | 系统厂商、客户基础设施团队 | 可以持续承接业务任务的计算集群 |
具体项目的分工随合同而变化。项目进入量产后,客户还要维护软件、扩大部署,并规划下一代芯片。
成本节省来自采购价格和任务效率
采购价格决定客户买到算力的成本
定制路线的产品价格同样包含供应商利润。客户比较的是包含这些利润后的整套采购与使用成本。
SemiAnalysis 在 2025 年 11 月的 TPU 研究中分析了这种空间:Google 采购 TPU 向 Broadcom 支付利润;NVIDIA 则通过其销售的 GPU、CPU、交换机和网卡等产品取得收益。该机构估算,Google 自用的特定 Ironwood 全系统配置,按芯片分摊后的总拥有成本(TCO,包含采购及使用成本)比 GB200 方案低约 44%。这项估算描述系统成本,完成任务的成本还取决于有效吞吐。(SemiAnalysis,TPUv7 研究)
从客户角度看,定制路线使一部分原先用于采购供应商产品的支出,转向自身研发与平台建设。最终节省多少,由双方的产品定价、系统配置和运行效率共同决定。UBS CIO 的研究也强调了销售价格与内部制造成本的口径差异;采购决策应使用客户实际支付的价格。(UBS CIO,PDF 第 14 页)
专门设计提高目标任务的效率
客户了解任务中的主要瓶颈,可以据此分配芯片面积、功耗和内存带宽,优化计算与数据搬运的比例。
Google TPU v4 的 SparseCore 是具体例子。搜索、广告和推荐模型使用大量 embedding 操作,即从庞大的特征表中查找、搬运和交换数据。SparseCore 专门加速这类处理。Google 论文报告,它占约 5% 的芯片面积和功耗,对依赖 embedding 的模型带来 5—7 倍加速;这一数字衡量 SparseCore 对相应模型的贡献。(Google TPU v4 论文)
这种设计把工程投入集中到客户大量执行的操作上。收益可以体现为更少的设备、更高的吞吐、更低的耗电,或更好的响应速度。对持续运行的大规模任务,每次处理节省的资源会累积成可观的年度成本差异。
同任务测试衡量最终产出成本
客户最终需要比较:在相同模型、质量和响应要求下,每次推荐、每个 token 或每次训练花费多少。
SemiAnalysis 于 2026 年 9 月发表的 InferenceX 预览测试,在 Qwen3.5 397B、FP8、8k 输入/1k 输出及集中式服务配置下,给出了以下估算。比较点的每用户生成速度均为 100 tokens/s:
| 加速器 | 每百万总 token 成本 | TPU 的相对成本差异 |
|---|---|---|
| Ironwood TPU | $0.181 | — |
| NVIDIA B200 | $0.222 | 约低 19% |
| NVIDIA B300 | $0.276 | 约低 34% |
这里采用外部客户采购 TPU 的 TCO 口径。测试吞吐与成本模型结合后,反映这一任务和服务配置下的单位产出成本。(SemiAnalysis,测试与方法)
测试状态为预览,硬件成本来自模型,页面内容按 22 Oct 2026 的可见版本读取。精度、首 token 延迟、并发和服务方式都是比较条件。Google 自身研发项目的回报,还需要加入它承担的研发和软件投入。
规模、软件复用与产品寿命决定回本
定制芯片有较大的前期投入。项目先取得单位任务成本优势,再靠足够的使用量积累节省,覆盖研发、软件和迁移支出。规模的作用是摊薄固定成本,并放大每次任务的节省。
Morgan Stanley 在 2023 年的定制芯片研究中,将前期设计费、规模带来的固定成本摊薄及供应商议价权放在一起讨论。这项历史研究提供了分析框架,具体项目成本需要使用对应代际和合同的数据。(Morgan Stanley 原研报,印刷页 20–21)
芯片寿命取决于后续模型对计算、内存和通信能力的需求。TPU 等加速器通过软件运行不同模型,客户持续更新编译器、算子和运行时,使新模型利用已有硬件。多代产品还可以复用接口、验证流程和机架设计;Meta 的模块化路线就以这种复用加快迭代。(Meta,MTIA 路线说明)
回本条件可以概括为:
核算时按合同归集各项费用,每笔费用计入一次,并考虑资金时间价值、延期和提前淘汰。持续维护的软件费用进入相应方案的运行成本。
GPU 路线的经济价值包括成熟软件、较快部署和跨任务调配能力。客户已有的软件积累、预计使用量,以及部署时点可购买的最新产品,共同决定它适合承担多少定制投入。任务明确、规模大且软件能力强的客户,更容易回收这笔投资。
系统费用也会影响回本。Morgan Stanley 在 2025 年研究的媒体转述中讨论了光连接、HBM、先进封装及软件工时对成本的影响。该来源为媒体转述,项目核算仍需取得实际报价和工程投入。(Morgan Stanley 研究的媒体转述)
TPU 的代际更新:旧设备用途、经济寿命与残值
新增 · 26 Oct 2026
芯片更新会改变旧设备能够承接的任务、每单位计算成本,以及后续出租和出售的价值。Google、NVIDIA 和研究机构从这些不同环节讨论设备寿命。
Google:多代 TPU 同时服务,设计需要预判任务持续性
2025 年 10 月,Google 的 AI 基础设施负责人 Amin Vahdat 在 a16z Runtime 活动上表示,公司当时有七代 TPU 同时服务内部和外部客户,七八年前的 TPU 利用率仍达到 100%。他将这一使用状况放在算力供给受电力、土地、许可和供应链约束的背景下讨论。(a16z,Google 与 Cisco 访谈,2025-10-29)
同一场访谈中,Vahdat 也指出,顶尖团队从专用芯片构想到生产部署,理想情况下需要约 2.5 年。因此,设计团队要预测未来的任务需求及其持续时间。这是专用硬件投资的重要风险:前期设计依据的工作量,要在芯片交付后继续支撑足够长时间的使用。
这些陈述提供了 Google 实际使用旧 TPU 的信息。各代设备的任务组合、利用率统计定义和净现金流,仍需更细的披露。
Google:更新由能效与系统改造共同决定
在 Sequoia 的另一场访谈中,Vahdat 介绍,旧 TPU 仍有显著使用量;Google 会结合约六年的折旧周期和新设备的能效安排更新。实际操作通常以整个 TPU pod 为单位,还要处理新旧系统占地和基础设施改造。(Sequoia,Amin Vahdat 访谈)
对客户而言,继续使用旧系统能节省新增采购,更换系统则可能提高有限电力与机房中的计算产出。更换时点取决于两种安排各自的成本和收益。约六年是访谈提到的折旧周期,具体设备的运行与更换由系统部署情况决定。
NVIDIA:软件更新和任务范围延长设备价值
NVIDIA 在 2026 年 10 月的官方文章中,将平台的长期回报归于产出能力、使用寿命和任务适用范围。它强调 CUDA 跨代软件支持及持续优化,使已安装 GPU 继续提升产出;旧设备还能转去承接其他 AI 阶段,以及科学计算、仿真和图形等工作。(NVIDIA,Productive, Durable, Fungible,2026-10-01)
这套竞争论述把 GPU 的灵活性转化为资产价值:一种任务需求下降时,更广的适用范围有助于设备继续找到工作。该文章是供应商对自身平台的说明,TPU 与 GPU 的实际寿命差异还需要同批设备的长期使用与交易数据。
Goldman Sachs:性能价格比和后续任务决定经济寿命
Goldman Sachs 将 AI 加速器常见的寿命假设列为 4—6 年,并讨论两股同时存在的力量:新一代产品的性能价格比改善,推动客户更新;推理、合成数据等后续任务扩大,为旧设备延续用途。其讨论覆盖 GPU 和 ASIC。(Goldman Sachs,The Economic Useful Life of AI Chips)
财务模型对使用年限的假设会直接影响项目回报。如果经济使用期缩短,客户需要更早购买新设备,并在更短时间内回收原有投资。这里应同时跟踪旧设备的任务收入、耗电、维护费用,以及新设备在同一部署条件下的产出。
Epoch AI 提供了另一种历史观察。其 2025 年研究统计芯片设计公开发布后,到最后一个已知采用它的前沿模型发表之间的跨度,较新芯片样本的中位数约为 3.9 年。该指标衡量前沿训练中的公开使用窗口;设备后续承接推理和其他任务的时间属于另一段使用记录。(Epoch AI,2025-03-05)
KBRA:租约到期后的客户和价格决定退出价值
评级机构 KBRA 于 2026 年 6 月发布 GPU、TPU 再出租风险研究。公开发布说明列出的评估因素包括:原客户续租、第三方需求、任务适配、芯片可替代性、软件转换成本、单位计算电力成本和更新策略。(KBRA,研究发布说明,2026-06-22)
原客户拥有现成软件和任务,可以继续使用旧设备;金融机构接手资产后,则需要找到愿意支付合适价格的客户。后者的需求范围与迁移成本,会影响再出租收入和处置价值。本轮取得的是 KBRA 官方发布说明,完整报告正文尚待取得,公开说明没有给出 TPU 相对 GPU 的残值折价比例。
这与 Broadcom 的客户融资相连:租约期间的设备利用率、租约到期后的续租能力,以及违约后的资产处置价格,分别影响不同阶段的现金回收。
产品服务的实际更新记录
2025 年 8 月,Colab 官方宣布将免费层 TPU v2-8 切换至 v5e-1,计划于同年 9 月完成。Cloud TPU 的 v2、v3 文档在 2026 年 10 月仍列有支持配置,支持终止日期标为未设定;v2 所用的 Cloud TPU API 进入缺陷和安全维护阶段,v3 可通过 GKE 管理。(Colab 官方公告;Cloud TPU v2;Cloud TPU v3)
这些记录呈现了服务渠道各自的更新安排。判断某代 TPU 的经济价值,还需要逐代任务分配、实际运行成本与二次租售成交记录。现有资料提供了运营方的使用陈述、供应商的平台论述和金融机构的评估框架,支持进一步追踪这些具体指标。
Broadcom 从开发、量产和多代合作取得利润
一项合作可以带来开发服务收入、量产芯片毛利,以及配套网络和连接产品收入。开发费用及风险分担按合同约定,量产芯片的采购价格则覆盖生产成本和 Broadcom 的产品利润。(Broadcom FY2025 10-K)
客户节省与供应商利润能够同时产生:定制方案相对于替代方案创造的价值,一部分由客户保留,一部分通过产品和服务价格由 Broadcom 取得。
项目量产后,利润取决于出货规模、单位毛利、软件与系统部署进度,以及下一代合作。多代项目复用底层 IP 和工程经验,使既有投入持续产生收入。客户也会根据成本、交付和技术路线选择设计伙伴,Broadcom 需要持续提供有竞争力的工程能力。
Broadcom 在 AI 基础设施中有两类相关产品:
- 定制 XPU承担计算任务,争取客户的计算硬件预算。
- 网络和连接芯片承担数据传输,可以服务 XPU 或 GPU 集群。
因此,Broadcom 的 AI 收入同时受计算平台选择和网络建设影响。配套产品的供应份额由各项设计与采购决定。
FY2026 Q3:需求转化为收入和现金流
本季度总收入 29.591b,同比增长约 86%;AI 半导体收入约 16.7b,同比增长 221%。收入增量主要来自 AI 半导体。(FY2026 Q3 财报;FY2025 Q3 财报)
| 业务口径 | FY2025 Q3 | FY2026 Q3 | 同比增量 |
|---|---|---|---|
| AI 半导体 | 约 5.2 | 约 16.7 | 约 11.5 |
| 非 AI 半导体(推算) | 约 3.966 | 约 4.139 | 约 0.173 |
| 基础设施软件 | 6.786 | 8.752 | 1.966 |
| 集团 | 15.952 | 29.591 | 13.639 |
AI 半导体贡献约 84% 的同比收入增量,占集团收入约 56%,包含定制加速器与 AI 网络产品。非 AI 半导体为半导体分部减 AI 半导体的近似值,受四舍五入影响。
半导体分部收入 20.839b、分部营业利润 12.770b,分部营业利润率约 61.3%。分部口径涵盖多类半导体产品,部分股权激励及收购摊销等费用列在集团未分摊项目中。集团本季度自由现金流(FCF,经营现金流减资本开支)为 13.665b,约占收入 46%。(FY2026 Q3 10-Q;FY2026 Q3 财报)
软件业务继续贡献利润和现金流;定制加速器与 AI 网络构成当前收入增长的主要来源。
客户融资把支付能力纳入交付链条
Broadcom 在 Q3 披露,为金融合作方承接的 AI 机架客户五年租赁义务提供担保支持(backstop)。全部机架部署后的最大潜在责任约 29b;截至报告期,相关担保的公允价值不重大,已支付金额为零。(FY2026 Q3 10-Q,Financial Guarantee)
这种安排使金融合作方购买设备,客户通过租赁取得算力。Broadcom 承担约定的担保责任,其风险敞口随部署、客户付款及设备处置价值变化。订单的经济质量因而同时取决于客户业务收入、租赁支付能力和设备剩余价值。
从需求到现金回收,可以沿以下环节跟踪:客户任务规模、芯片和软件就绪程度、实际单位任务成本、量产与数据中心部署进度,以及客户付款。现有财报提供收入、利润和担保责任,公开案例提供任务与产品进展;单个项目的完整开发费、采购价、软件工时和实际回本期仍待披露。